
Kies een model in Ollama. Gebruik het in WebBrain.
WebBrain kan vandaag het lokale OpenAI-compatibele eindpunt van Ollama gebruiken. Configureer het bij Instellingen met de officiële Ollama-release, of probeer de preview-launch-overdracht die model, eindpunt en contextvenster naar WebBrain stuurt voor goedkeuring met één klik.
ollama launch webbrain maakt nog geen deel uit van upstream Ollama-builds. Het normale Instellingen-pad werkt met de officiële release; de overdracht met één opdracht vereist op dit moment de gelinkte preview-tak.
Kies het pad dat bij uw Ollama-versie past
| Pad | Wanneer gebruiken | Wat u doet |
|---|---|---|
| Provider handmatig configureren | U hebt een officiële Ollama-release geïnstalleerd. | Start Ollama met toegestane extensie-origins en voer in de WebBrain-instellingen het lokale eindpunt en model in. |
| Launch-overdracht | U hebt de huidige preview-tak gebouwd en wilt de kortste installatie. | Voer ollama launch webbrain --model <model> uit, controleer de browserprompt en keur de providerwijziging goed. |
Configureer de officiële Ollama-release handmatig
- Installeer Ollama en pull een geschikt model.Kies een model dat toolcalls betrouwbaar volgt. Agentruns vereisen minimaal een contextvenster van 16k tokens.
- Sta browserextensie-origins toe.Sluit een ander Ollama-desktopproces als dat al poort
11434in beslag neemt, en start de server vanuit een terminal met de onderstaande origin-allowlist. - Open de WebBrain-providerspagina.Kies Meer… in het modelmenu van de zijbalk, zoek Ollama (Local) op het LLM-tabblad en open de kaart.
- Voer het eindpunt en model in.Gebruik
http://localhost:11434/v1en selecteer daarna het model dat u pullde. - Sla op en test de verbinding.Gebruik Modellen laden om WebBrain de beschikbare model-ID's te laten uitlezen en het live contextvenster te laten detecteren.
- Stel in als actief.Begin met het Mid-promptniveau. Gebruik Compact alleen als de context van het model beperkt is.
ollama pull <model>
OLLAMA_ORIGINS="chrome-extension://*,moz-extension://*" ollama servecurl verzendt geen browserextensie-origin. Als Ollama in een terminal werkt maar faalt in WebBrain, start de Ollama-server opnieuw met OLLAMA_ORIGINS in plaats van de provider-URL te wijzigen.
Probeer de Ollama-launch-overdracht
De previewopdracht opent een WebBrain-launch-URL met het geselecteerde model, het lokale loopback-eindpunt /v1 en het gedetecteerde contextvenster. De extensie toont deze waarden in een bevestigingsdialoog voordat er iets verandert.
git clone https://github.com/esokullu/ollama.git
cd ollama
git switch codex/ollama-webbrain-launch-handoff
cmake -S . -B build -G Ninja -DOLLAMA_MLX_BACKENDS=
cmake --build build --parallel 8

OLLAMA_ORIGINS="chrome-extension://*,moz-extension://*" ./ollama serve
Houd de server draaiend. Vervang in een andere terminal het voorbeeldmodel door een model dat beschikbaar is in uw lokale Ollama-installatie:
./ollama launch webbrain --model qwen3.5:9b- Laat de opdracht webbrain.one openen.De extensie accepteert deze overdracht alleen op de WebBrain Ollama-launchpagina.
- Bekijk de bevestiging.Controleer het model, de lokale loopback-provider-URL en het contextvenster.
- Keur de wijziging goed.WebBrain werkt de lokale Ollama-provider bij en stelt deze als actief in.
- Open de zijbalk.De actieve provider zou nu Ollama (Local) moeten tonen.
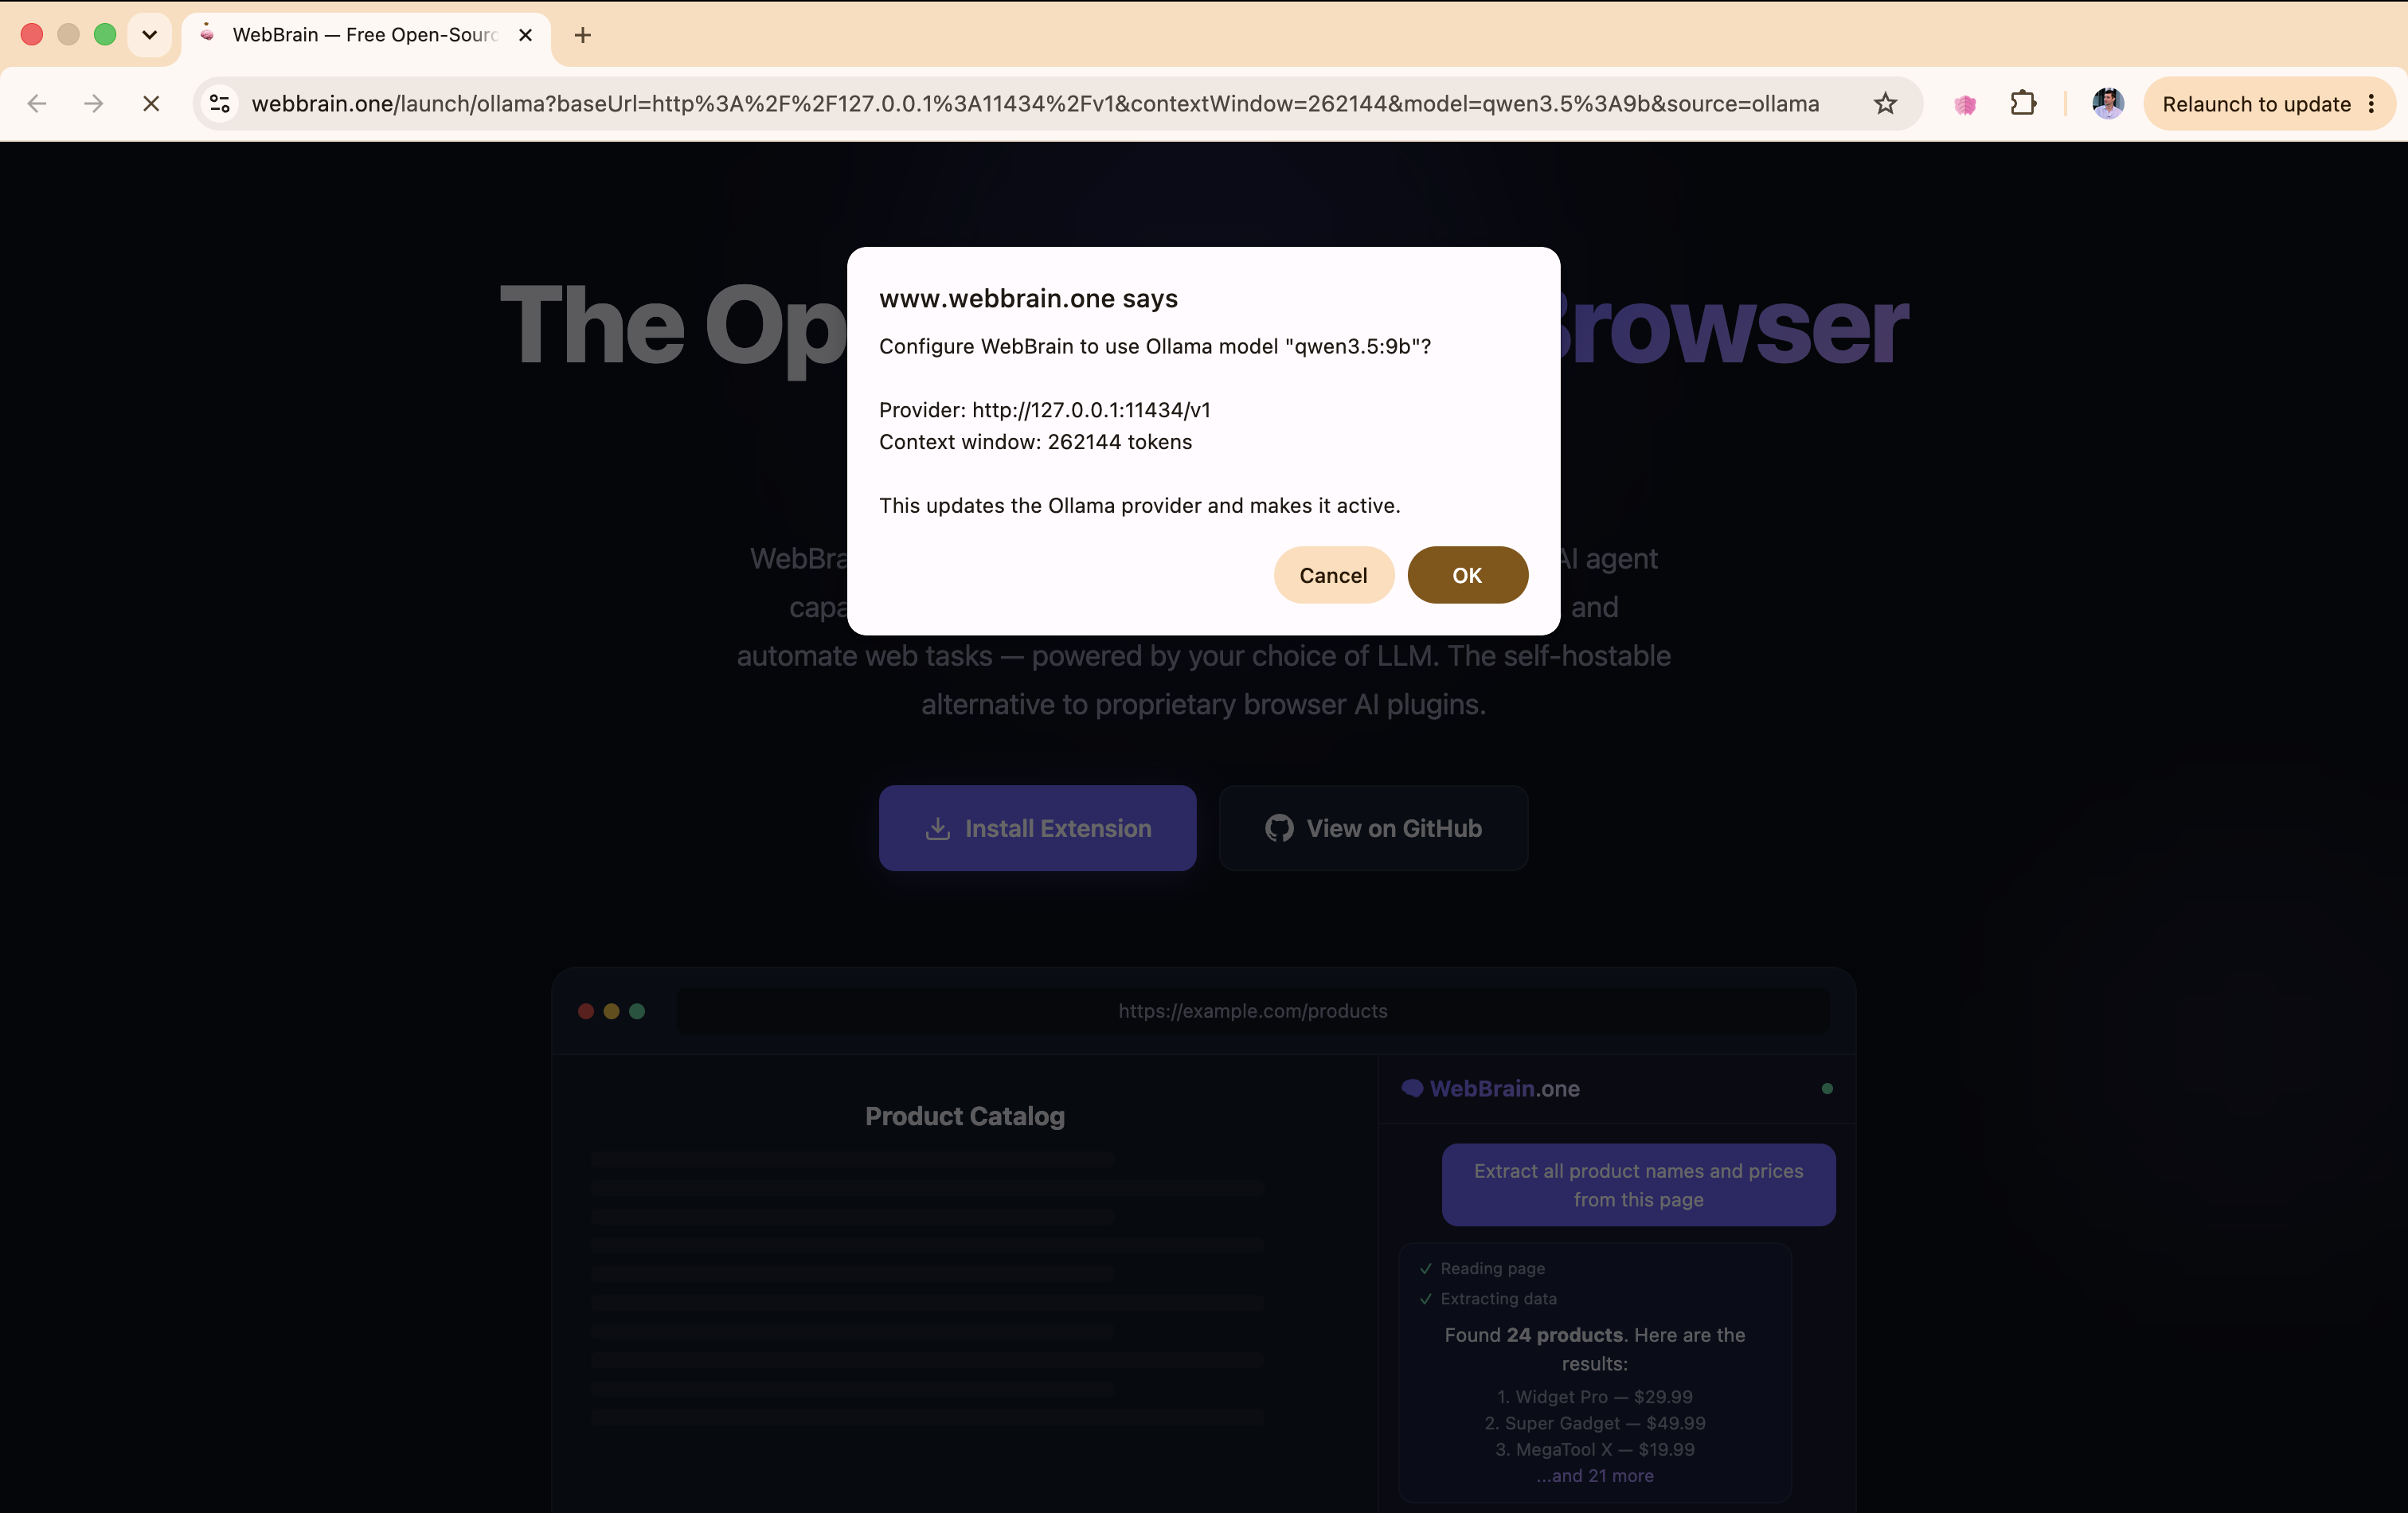
WebBrain accepteert alleen een lokale loopback-Ollama-host, een HTTP(S)-URL zonder ingebedde aanmeldgegevens en het OpenAI-compatibele /v1-eindpunt. De modelnaam en het contextvenster worden genormaliseerd voordat de provider wordt opgeslagen.
Kies een model en context die een agent kunnen aandrijven
- Begin bij 16k context of hoger.Dat is het praktische minimum voor de systeemprompt, browsertools, pagina-inhoud en een nuttige gespreksgeschiedenis.
- Toolgebruik-training is belangrijk.Een model dat gewone chat goed beantwoordt, kan nog steeds onjuiste of ontbrekende toolcalls produceren.
- Gebruik eerst Mid.Het toont de veelgebruikte browsertoolset met lagere promptkosten. Compact kan rond 8k helpen; 4k is te klein om betrouwbaar te draaien.
- Vision verschilt per model.Schakel vision alleen in als het Ollama-model dat u bedient afbeeldingen accepteert.
- Test het live model.Verbinding testen en Modellen laden kunnen de runtime-informatie van Ollama uitlezen en het gedetecteerde contextvenster vernieuwen.
Problemen oplossen per symptoom
| Symptoom | Waarschijnlijke oorzaak | Oplossing |
|---|---|---|
| WebBrain meldt 403 | Ollama wees de extensie-origin af. | Start de server opnieuw met OLLAMA_ORIGINS="chrome-extension://*,moz-extension://*". |
| Verbinding geweigerd | Ollama is gestopt, of WebBrain gebruikt de verkeerde poort. | Voer ollama serve uit en houd de basis-URL op http://localhost:11434/v1. |
| Model niet gevonden | De opgeslagen model-ID komt niet exact overeen met de Ollama-catalogus. | Voer ollama list uit of gebruik Modellen laden en kopieer daarna de volledige modelnaam inclusief tag. |
| Het model chat in plaats van browsertools te gebruiken | Het model is zwak in toolgebruik, of het context-/promptniveau is te beperkt. | Probeer een op toolgebruik getraind model, vergroot de context of ga van Compact naar Mid. |
ollama launch onbekende opdracht | U draait een upstream Ollama-build. | Gebruik de handmatige providerinstellingen of bouw de gelinkte preview-tak. |
| De launchpagina opent maar er verschijnt geen prompt | De WebBrain-extensie ontbreekt, is uitgeschakeld of verouderd. | Schakel de huidige extensie in op webbrain.one, herlaad de launchpagina en voer de opdracht opnieuw uit. |
Voor het aankondigingsartikel, screenshots en de huidige preview-ontwerpoverwegingen, lees WebBrain heeft nu een Ollama-launch-overdracht.