
अपने धैर्य, गोपनीयता ज़रूरतों और बजट के मुताबिक सेटअप चुनें।
WebBrain में 114 प्रोवाइडर कार्ड बिल्ट-इन हैं, जिनमें होस्टेड क्लाउड सेवाएँ, डायरेक्ट क्लाउड API, मॉडल राउटर और लोकल OpenAI-संगत सर्वर शामिल हैं। आपको केवल एक सक्रिय प्रोवाइडर की ज़रूरत होती है।
त्वरित चुनाव
WebBrain Compass
बिल्ट-इन और डिफ़ॉल्ट रूप से सक्रिय; इसमें दैनिक निःशुल्क कोटा शामिल है। न मॉडल सर्वर चाहिए, न API कुंजी।
लोकल मॉडल
llama.cpp, Ollama, ODS, LM Studio, Jan, vLLM, SGLang या LocalAI का उपयोग करें।
क्लाउड API
OpenAI, Anthropic, Gemini, Mistral, DeepSeek, xAI, Groq जैसे समर्थित प्रोवाइडरों के लिए अपनी कुंजी भरें।
मॉडल राउटर
एक ही खाते से कई मॉडलों में बदलें; बार-बार आज़माने वाले उपयोगकर्ताओं के लिए उपयुक्त।
114 बिल्ट-इन प्रोवाइडर कार्ड
प्रोवाइडर पेज में 79 अतिरिक्त डायरेक्ट API और राउटर जोड़े गए हैं, जिनमें Azure AI Foundry, Vertex AI, Vertex Anthropic, Cerebras, Cohere, DeepInfra, Perplexity, Vercel AI Gateway, Venice और कई क्षेत्रीय कोडिंग प्लान शामिल हैं। पूरी सूची स्क्रॉल करने के बजाय प्रोवाइडर या मॉडल के नाम से खोजें।
ज़्यादातर कार्ड API कुंजी और OpenAI-संगत एंडपॉइंट उपयोग करते हैं। Vertex कार्ड Google Cloud परियोजना, लोकेशन और ऑथराइज़ेशन कुंजी उपयोग करते हैं; ग्लोबल लोकेशन Google के ग्लोबल एंडपॉइंट का उपयोग करती है, जबकि Vertex Anthropic us और eu मल्टी-रिजन होस्ट भी समर्थित करता है। Cloudflare वैकल्पिक AI Gateway ID स्वीकार करता है; @cf/ मॉडलों के लिए फ़ील्ड खाली छोड़ने पर स्वतः default गेटवे उपयोग होता है। जिन प्रोवाइडरों में स्ट्रीमिंग समर्थित है, वे इंटरैक्टिव Ask में जवाब रियल-टाइम में दिखाते हैं, और कनेक्शन जल्दी टूटने पर एक बार बिना स्ट्रीमिंग के स्वतः फिर कोशिश करते हैं। जब सेवा टोकन उपयोग लौटाती है तो वह सीधे दर्ज होता है; अन्यथा WebBrain एक सतर्क अनुमान दर्ज करता है, ताकि स्ट्रीमिंग अनुरोध लागत सीमा को पार न कर सकें।
GitHub ख़ुद नहीं बंद हो रहा, लेकिन GitHub Models 30 जुलाई 2026 को रिटायर हो रहा है। GitHub Copilot के लिए अलग सब्सक्रिप्शन/OAuth इंटीग्रेशन चाहिए। GitLab Duo और SAP AI Core को भी ऐसी कस्टम ऑथेंटिकेशन और डिप्लॉयमेंट डिस्कवरी चाहिए जो ब्राउज़र एक्सटेंशन में समर्थित नहीं हैं।
कॉन्फ़िगर करने के चरण
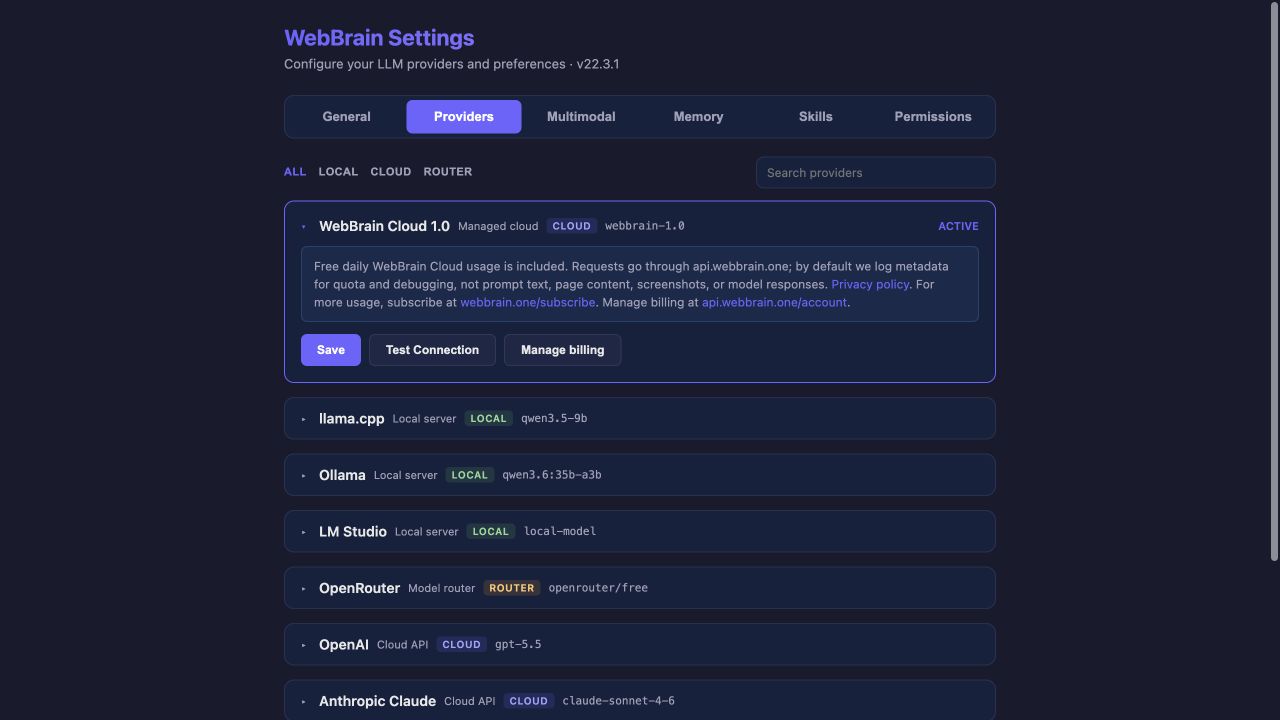
- प्रोवाइडर पेज खोलें। साइडबार के मॉडल मेनू में More… चुनें, या सेटिंग्स पेज के शीर्ष पर दिए Providers लिंक पर क्लिक करें। LLM टैब चैट प्रोवाइडरों की सूची दिखाता है।
- प्रोवाइडर खोजें। Local, Cloud, Router या सर्च फ़ील्ड का उपयोग करें।
- कार्ड खोलें और मान भरें। लोकल सर्वरों को आमतौर पर पता और मॉडल का नाम चाहिए; क्लाउड प्रोवाइडरों को API कुंजी भी चाहिए।
- सेव करें। मौजूदा फ़ील्ड ब्राउज़र में स्टोर हो जाते हैं।
- Test Connection दबाएँ। आगे बढ़ने से पहले पता, कुंजी, मॉडल या सर्वर की ग़लती ठीक करें।
- Set Active करें। केवल टेस्ट सफल होने के बाद। सेव करना इस बात का मतलब नहीं कि वही प्रोवाइडर सक्रिय है।
फ़ील्ड्स का मतलब
| फ़ील्ड | मतलब | सुझाव |
|---|---|---|
| सर्वर / Base URL | OpenAI-संगत रूट एंडपॉइंट या प्रोवाइडर API का रूट पता। | अपने लोकल ऐप या प्रोवाइडर द्वारा दिया गया सटीक मान उपयोग करें; चैट वेबपेज का पता न चिपकाएँ। |
| API कुंजी | प्रोवाइडर को भेजी जाने वाली, प्रमाणीकरण के लिए क्रेडेंशियल। | लोकल सर्वरों को आमतौर पर इसकी ज़रूरत नहीं, सिवाय इसके कि आपने स्वयं ऑथेंटिकेशन चालू किया हो। |
| मॉडल | सर्वर द्वारा अपेक्षित मॉडल पहचानकर्ता। | बड़े-छोटे अक्षर, उपसर्ग और वर्तनी बिल्कुल सटीक होने चाहिए। |
| कंटेक्स्ट विंडो | एक अनुरोध में कितना प्रॉम्प्ट, इतिहास, पेज सामग्री और टूल स्कीमा समा सकता है। | भरोसेमंद लोकल रन के लिए कम से कम 16k आदर्श; 8k Compact के साथ चल सकता है; 4k बहुत छोटा। |
| विज़न सपोर्ट | चुना गया मॉडल इमेज स्वीकार करता है या नहीं। | केवल तभी चालू करें जब सेवा कर रहे सटीक मॉडल में इमेज समर्थित हो। |
| प्रॉम्प्ट टियर | WebBrain कितने लंबे प्रॉम्प्ट और सामान्य ब्राउज़र टूल सेट का उपयोग करता है। | लोकल मॉडलों के लिए Mid से शुरू करें; छोटे कंटेक्स्ट के लिए Compact, सक्षम मॉडलों के लिए Full। |
लोकल मॉडल: अतिरिक्त कड़ियाँ
| सर्वर | आम तौर पर Base URL | API कुंजी |
|---|---|---|
| llama.cpp | http://localhost:8080 | आमतौर पर ज़रूरत नहीं |
| Ollama | http://localhost:11434/v1 | ज़रूरत नहीं |
| ODS | http://localhost:11434/v1 | वैकल्पिक; ODS .env में दिया गया पोर्ट उपयोग करें |
| LM Studio | http://localhost:1234/v1 | ज़रूरत नहीं |
| Jan | http://localhost:1337/v1 | वैकल्पिक |
| vLLM | http://localhost:8000/v1 | वैकल्पिक |
| SGLang | http://localhost:30000/v1 | वैकल्पिक |
कनेक्शन रिजेक्ट होने का मतलब आमतौर पर सर्वर बंद है या पोर्ट ग़लत है; CORS/Origin त्रुटि के लिए ब्राउज़र एक्सटेंशन के ओरिजिन की अनुमति देनी होती है। Ollama के लिए आम कमांड: OLLAMA_ORIGINS="chrome-extension://*,moz-extension://*" ollama serve।
प्रॉम्प्ट टियर आसान भाषा में
क्लाउड प्रोवाइडर हमेशा Full उपयोग करते हैं; लोकल प्रोवाइडर डिफ़ॉल्ट रूप से Mid; Compact प्रोवाइडर Dev मोड उपयोग नहीं कर सकते।
जब Test Connection फेल हो
- Connection refused: लोकल सर्वर चालू करें और पोर्ट की पुष्टि करें।
- CORS/Origin: सर्वर में WebBrain एक्सटेंशन के ओरिजिन की अनुमति दें।
- Unauthorized: सुनिश्चित करें कि कुंजी और Base URL एक ही प्रोवाइडर के हैं।
- Model not found: मॉडल का सटीक ID कॉपी करें, या Load models उपयोग करें।
- टाइमआउट: CPU पर चलने वाले बड़े लोकल मॉडलों के लिए “Settings → Budgets” में LLM request timeout बढ़ाएँ।
- कुछ चक्करों के बाद फेल: वास्तविक कंटेक्स्ट विंडो की पुष्टि करें; प्रॉम्प्ट टियर घटाएँ या मॉडल को बड़े कंटेक्स्ट के साथ लोड करें।
वैकल्पिक सहायक मॉडल
सक्रिय प्रोवाइडर मुख्य बातचीत, प्लानिंग और अंतिम जवाब संभालता है। प्रोवाइडर पेज के अन्य टैब में विज़न मॉडल, स्पीच (speech-to-text) एंडपॉइंट, जेनरेटिव मीडिया, डीसिज़न मॉडल और SafeSocial अलग से कॉन्फ़िगर किए जा सकते हैं। ये सेटिंग्स प्रोवाइडर फ़िल्टर या बदलाव से प्रभावित नहीं होतीं।
विज़न और डीसिज़न मॉडल डिफ़ॉल्ट रूप से Auto होते हैं: Chrome में Compass VLD v6 2B के डाउनलोड हो जाने के बाद उसका उपयोग होता है (अगर केवल पुराना Compass VLD Tiny v5 डाउनलोड है तो Tiny v5; अगर दोनों नहीं हैं पर Ternary Bonsai 2 2B Vision या D1 डाउनलोड है तो स्क्रीनशॉट के लिए पहला और डीसिज़न के लिए दूसरा; जब WebBrain Cloud सक्रिय हो तो तब तक डीसिज़न Compass के मैनेज्ड डीसिज़न मॉडल से होते हैं जब तक इनमें से कुछ डाउनलोड न हो जाए), डाउनलोड से पहले कोई उपयोग नहीं। डीसिज़न मॉडल केवल “क्या यह टास्क पूरा हो गया?” जैसे हाँ/ना और मल्टीपल-चॉइस सवालों के जवाब देता है; On चुनने पर OpenRouter, TypeSafe, लोकल सर्वर, D1 या ब्राउज़र-इन मॉडल हर डीसिज़न का जवाब देते हैं, और Off चुनने पर कभी नहीं। मौजूदा अनुमतियाँ और पूर्णता जाँच लागू रहती हैं। कॉन्फ़िगरेशन और डेटा-शेयरिंग की जानकारी के लिए विज़न, स्पीच और डीसिज़न मॉडल देखें।