
Pilih pengaturan yang sesuai dengan kesabaran, kebutuhan privasi, dan anggaran Anda.
WebBrain menyertakan 114 kartu penyedia, mencakup layanan cloud terkelola, API cloud langsung, router model, dan server OpenAI-kompatibel lokal. Anda hanya perlu satu penyedia aktif.
Pilihan cepat
WebBrain Compass
Sudah terpasang, aktif secara default, termasuk kuota gratis harian; tanpa server model atau kunci API.
Model lokal
Gunakan llama.cpp, Ollama, ODS, LM Studio, Jan, vLLM, SGLang, atau LocalAI.
API cloud
Isi kunci Anda sendiri untuk OpenAI, Anthropic, Gemini, Mistral, DeepSeek, xAI, Groq, dan penyedia yang didukung lainnya.
Router model
Beralih di antara banyak model dengan satu akun; cocok bagi yang sering bereksperimen.
114 kartu penyedia bawaan
Halaman penyedia menambahkan 79 API langsung dan router, termasuk Azure AI Foundry, Vertex AI, Vertex Anthropic, Cerebras, Cohere, DeepInfra, Perplexity, Vercel AI Gateway, Venice, dan banyak paket pemrograman regional. Cari berdasarkan nama penyedia atau model.
Sebagian besar kartu menggunakan kunci API dan endpoint OpenAI-kompatibel. Kartu Vertex menggunakan proyek Google Cloud, wilayah, dan kunci otorisasi; wilayah global memakai endpoint global Google, dan Vertex Anthropic juga mendukung host multi-wilayah us dan eu. Cloudflare menerima ID AI Gateway opsional; untuk model @cf/, jika kolom dikosongkan, gateway default dipakai otomatis. Penyedia yang mendukung streaming menampilkan balasan secara langsung di Ask interaktif, dan saat koneksi terputus lebih awal, otomatis mencoba sekali lagi tanpa streaming. Ketika layanan mengembalikan pemakaian token, hal itu dicatat langsung; jika tidak, WebBrain mencatat estimasi konservatif agar permintaan streaming tidak melewati batas biaya.
GitHub sendiri tidak akan tutup, tetapi GitHub Models pensiun pada 30 Juli 2026. GitHub Copilot memerlukan langganan atau integrasi OAuth terpisah. GitLab Duo dan SAP AI Core juga memerlukan autentikasi khusus dan penemuan deployment yang tidak didukung ekstensi peramban.
Langkah penyiapan
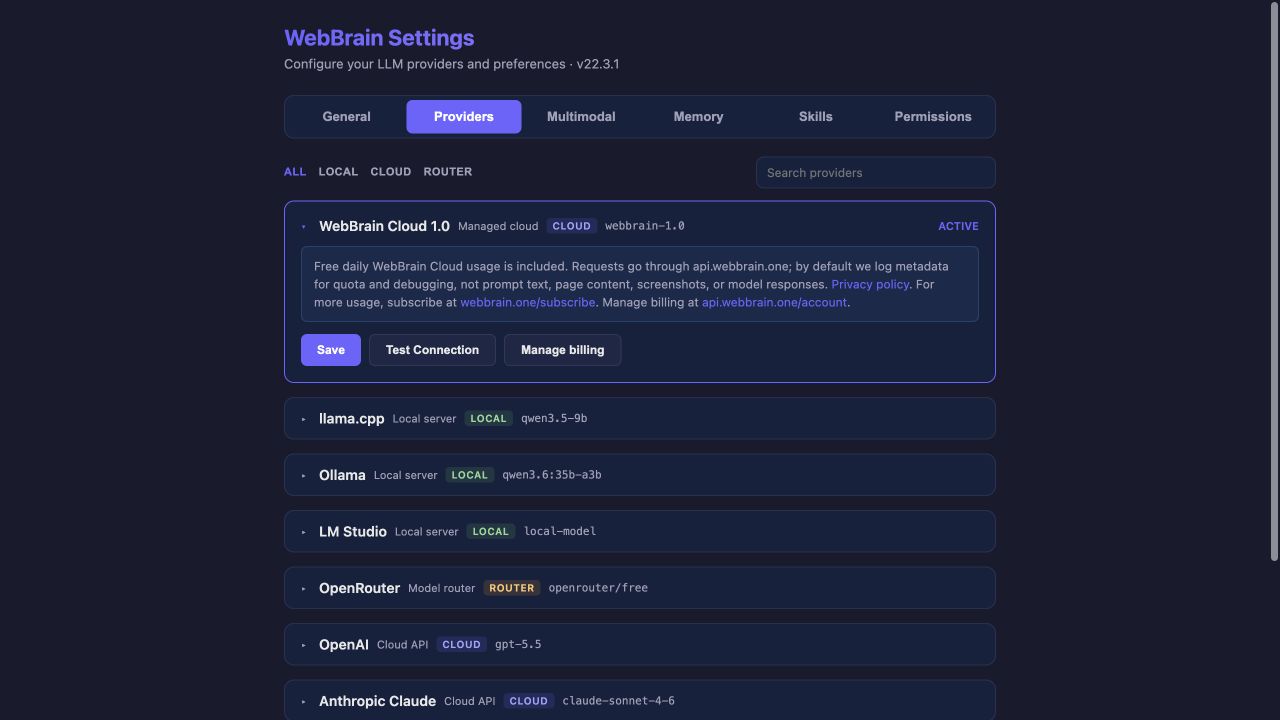
- Buka halaman penyedia. Pilih Lainnya… di menu model bilah sisi, atau tautan “Penyedia” di bagian atas halaman pengaturan. Tab LLM mencantumkan penyedia chat.
- Temukan penyedia. Gunakan “Lokal”, “Cloud”, “Router”, atau kotak pencarian.
- Bentangkan kartu dan isi nilainya. Server lokal biasanya memerlukan alamat dan nama model; penyedia cloud juga memerlukan kunci API.
- Simpan. Menulis kolom saat ini ke peramban.
- Uji koneksi. Perbaiki kesalahan alamat, kunci, model, atau server terlebih dahulu.
- Jadikan aktif. Beralih hanya setelah uji berhasil. Menyimpan tidak berarti sudah diaktifkan.
Arti kolom
| Kolom | Arti | Saran |
|---|---|---|
| Server / Base URL | Endpoint root OpenAI-kompatibel atau akar API penyedia. | Gunakan nilai persis yang diberikan aplikasi lokal atau penyedia Anda; jangan menempelkan alamat halaman chat. |
| Kunci API | Kredensial yang dikirim ke penyedia untuk autentikasi. | Server lokal biasanya tidak memerlukan, kecuali Anda mengaktifkan autentikasi. |
| Model | Pengidentifikasi model yang diharapkan server. | Huruf besar/kecil, awalan, dan ejaan harus tepat. |
| Jendela konteks | Kapasitas prompt, riwayat, isi halaman, dan skema tool dalam satu permintaan. | Minimal 16k agar andal berjalan lokal; 8k bisa dengan Compact; 4k terlalu kecil. |
| Dukungan visi | Apakah model saat ini menerima gambar. | Aktifkan hanya jika model persis yang dilayani dipastikan mendukung gambar. |
| Level prompt | Panjang prompt dan cakupan tool peramban biasa yang dipakai WebBrain. | Mulai dari Mid untuk model lokal; Compact untuk konteks kecil, Full untuk model tangguh. |
Tambahan untuk model lokal
| Server | Base URL umum | Kunci API |
|---|---|---|
| llama.cpp | http://localhost:8080 | Umumnya tidak perlu |
| Ollama | http://localhost:11434/v1 | Tidak perlu |
| ODS | http://localhost:11434/v1 | Opsional; gunakan port di .env ODS |
| LM Studio | http://localhost:1234/v1 | Tidak perlu |
| Jan | http://localhost:1337/v1 | Opsional |
| vLLM | http://localhost:8000/v1 | Opsional |
| SGLang | http://localhost:30000/v1 | Opsional |
Koneksi ditolak biasanya berarti server belum berjalan atau port salah; galat CORS/Origin memerlukan izin asal ekstensi peramban. Umum untuk Ollama: OLLAMA_ORIGINS="chrome-extension://*,moz-extension://*" ollama serve.
Level prompt
Penyedia cloud tetap memakai Full; penyedia lokal default Mid; penyedia Compact tidak dapat memakai mode Dev.
Saat uji koneksi gagal
- Connection refused: Jalankan server lokal dan pastikan port.
- CORS/Origin: Izinkan asal ekstensi WebBrain di server.
- Unauthorized: Pastikan kunci dan Base URL milik penyedia yang sama.
- Model not found: Salin ID model persis, atau gunakan Load models.
- Waktu habis: Naikkan batas waktu permintaan LLM di “Pengaturan → Anggaran” untuk model CPU lokal besar.
- Gagal setelah beberapa giliran: Pastikan jendela konteks sebenarnya; turunkan level prompt atau perbesar konteks model.
Model bantu opsional
Penyedia aktif menangani percakapan utama, perencanaan, dan balasan akhir. Tab lain pada halaman penyedia dapat mengonfigurasi secara terpisah model Vision, endpoint Speech (suara ke teks), media Generative, model Decision, dan SafeSocial. Pengaturan ini tidak terpengaruh oleh filter atau pergantian penyedia.
Model Vision dan Decision secara default berada di Auto: di Chrome, Compass VLD v6 2B dipakai setelah selesai diunduh (Compass VLD Tiny v5 jika hanya itu yang diunduh; jika keduanya tidak ada dan hanya Ternary Bonsai 2 2B Vision atau D1 yang diunduh, yang pertama membaca tangkapan layar dan yang kedua menangani keputusan; saat WebBrain Cloud aktif, keputusan ditangani model keputusan terkelola Compass), dan tidak ada sebelum unduhan. Model keputusan hanya menjawab ya/tidak dan pilihan ganda seperti “Sudah selesai tugas ini?”; pilih On agar OpenRouter, TypeSafe, server lokal, D1, atau model dalam peramban menjawab semua keputusan, atau Off untuk tidak pernah memakainya. Izin dan pemeriksaan penyelesaian yang ada tetap berlaku. Cara konfigurasi dan pembagian data lihat Model visi, suara, dan keputusan.